Sekitar 85 bahasa
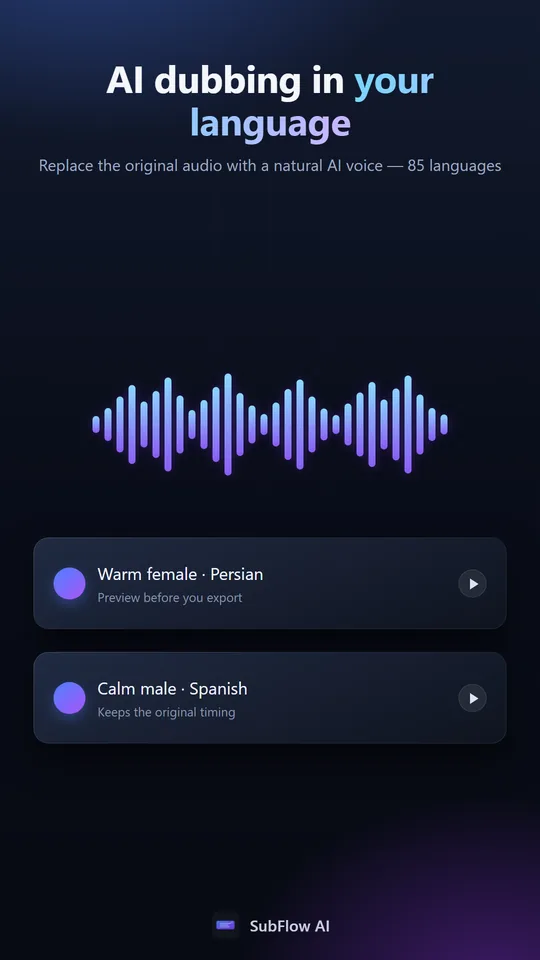
Dua penyedia suara bersama-sama mencakup sekitar 97% bahasa target yang benar-benar dipilih pengguna di sini, termasuk Persia dan Arab.
Dubbing video AI
Subjudul mengharuskan orang membaca. Dubbing memungkinkan mereka mendengar. SubFlow mentranskripsikan ucapan, menerjemahkannya, lalu mengucapkannya kembali dengan suara AI yang disinkronkan ke aslinya — dalam sekitar 85 bahasa.
30 menit gratis per bulan · Tanpa kartu kredit · 99+ bahasa
Dubbing tersedia di aplikasi SubFlow untuk Android dan HarmonyOS. Di web, Anda dapat membuat, mengedit, dan mengekspor subtitle.
Dua penyedia suara bersama-sama mencakup sekitar 97% bahasa target yang benar-benar dipilih pengguna di sini, termasuk Persia dan Arab.
Setiap baris disesuaikan dengan celah yang tersedia, sehingga dubbing mengikuti gambar alih-alih semakin meleset di setiap kalimat.
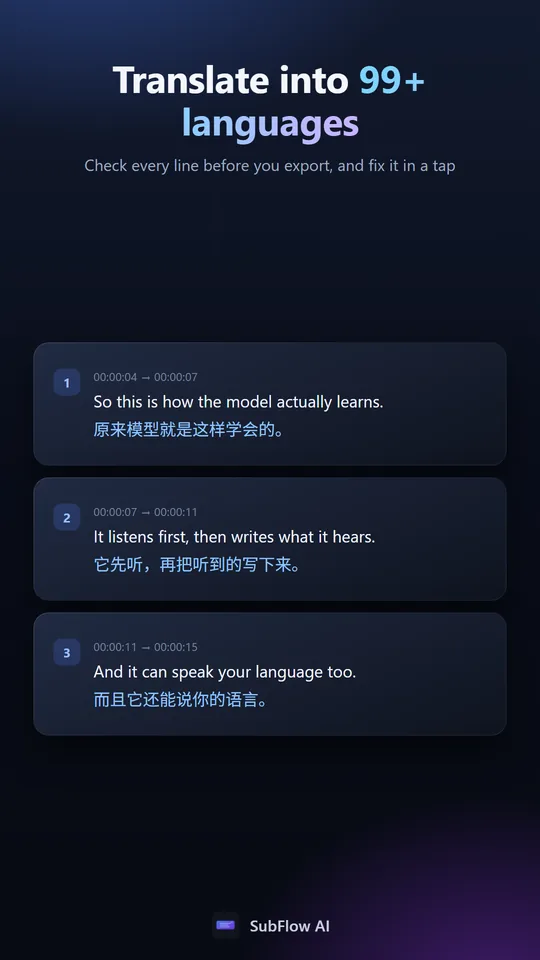
Dubbing diucapkan dari subtitle terjemahan, jadi memperbaiki nama atau istilah di editor langsung mengubah apa yang diucapkan suara.
Workflow
Tambahkan video atau audio. SubFlow menuliskan ucapan sebagai caption berbasis waktu dalam bahasa aslinya.
Pilih bahasa tujuan, periksa terjemahannya baris per baris, lalu pilih suara yang tersedia untuk bahasa tersebut.
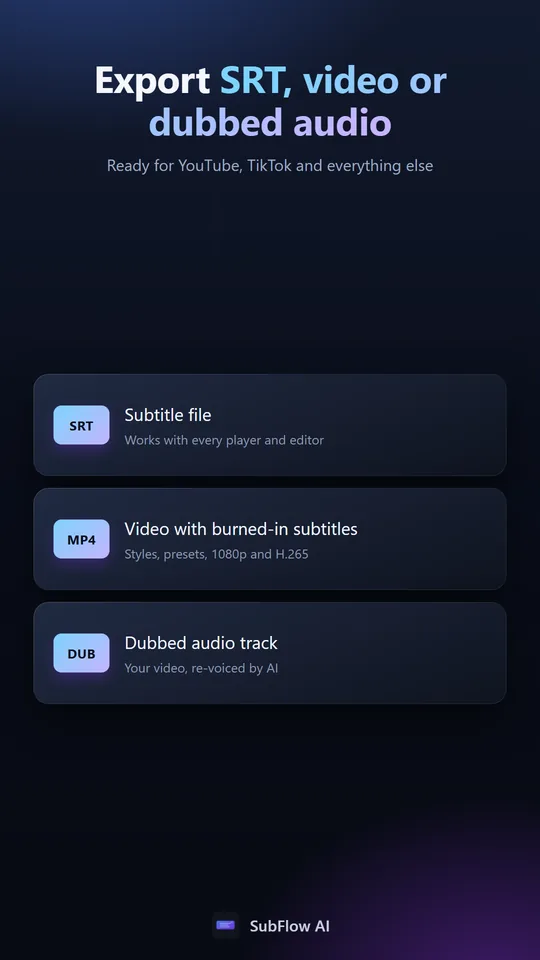
Ambil track audio dubbing saja, atau video jadi dengan suara baru yang sudah terpasang.
In the app
Common questions
Sekitar 85 bahasa, termasuk Persia, Arab, Spanyol, Portugis, Indonesia, Turki, Hindi, Jepang, Korea, dan Tiongkok. Daftar suara untuk bahasa pilihan Anda ditampilkan sebelum Anda menghasilkan apa pun.
Setiap baris disesuaikan dengan jendela waktunya, menggunakan celah sebelum baris berikutnya bila tersedia, sehingga sinkronisasi tidak meleset sepanjang video panjang.
Ya. Dubbing dihasilkan dari subtitle terjemahan, jadi cukup edit barisnya dan hasilkan ulang segmen tersebut.
File sumber Anda tidak diubah. Ekspor track dubbing secara terpisah, atau video dengan suara baru — sesuai kebutuhan Anda.
Tidak. Dubbing hanya tersedia di paket Pro; subtitle dan terjemahan tersedia di semua paket, termasuk versi gratis.
Suara-suara ini menggunakan teknologi neural text-to-speech, namun nilai utamanya ada pada keseluruhan proses: pengenalan ucapan, penerjemahan kontekstual, dan sinkronisasi tiap baris ke gambar.